



Ollama är ett verktyg för att hämta och köra öppna språkmodeller lokalt eller i egen molnmiljö: CLI, lokal HTTP-API och ett modellbibliotek med pull-by-name. Koden licensieras MIT.

llama.cpp
AI-körning och modellserver · Inferensmotor för stora språkmodeller (lokal körning)
llama.cpp är en MIT-licensierad inferensmotor för kvantiserade språkmodeller i GGUF-format som kör på CPU och GPU, med kommandoradsverktyg och en OpenAI-kompatibel server.
Betyg 91 av 100 Preliminär (källbaserad)
Läs bedömningenAPI · Officiellt
llama-server, OpenAI-kompatibel
Kontrollerat:
MCP · Officiellt
konsumerar MCP via stdio, experimentell
Kontrollerat:

Bedömning
Så bedömer viTotalbetyg
91 av 100
Preliminär (källbaserad)
-
Öppenhet och kontroll
Ren MIT (OSI), full frihet att läsa/ändra/återdistribuera; ingen kommersiell låsning.
-
Funktionell passform
GGUF-referensimplementationen täcker effektiv kvantiserad inferens utan luckor, inkl. kvantiseringsverktyg.
-
Dataflytt och interoperabilitet
GGUF är branschens öppna de facto-standard, delbar mellan runtimes; backends för CPU/CUDA/Metal/Vulkan/ROCm.
-
Mognad och trygghet
Aktivt sedan 2023 med tusentals bidragsgivare och djupt inbäddat i ekosystemet; etablerat men inte med den långa historik som ankare 5 kräver.
-
Framtidskraft
llama-server ger OpenAI-kompatibelt API med verktygsanrop; CLI-först men agentramverk integrerar via API.
-
Drift och införande
Färdiga binärer för de flesta plattformar; normalfallet är nedladdad binär + GGUF-fil.
-
Kostnadsbild
MIT, gratis, körs även på CPU — transparent och väl avvägd TCO via kvantisering.
-
Svensk användbarhet
Språkneutral runtime — svensk förmåga följer modellen; inga svenskspecifika funktioner.
Om llama.cpp
Projektet utvecklas under MIT-licensen hos ggml-organisationen och är en referensimplementation för GGUF, den öppna de facto-standarden för kvantiserade modeller. Modeller körs på såväl CPU som GPU, och förbyggda binärer för de vanliga skrivbordssystemen sänker tröskeln: en nedladdad binär och en GGUF-fil räcker för att komma igång. Kvantiseringen gör att modeller kan köras på betydligt mindre maskiner än vikternas råstorlek antyder, och backends täcker CUDA, Metal, Vulkan med flera.
Utöver kommandoradsverktygen finns llama-server, en HTTP-server som exponerar modellen med ett OpenAI-kompatibelt gränssnitt och stöd för verktygsanrop. En experimentell del kan även ansluta externa MCP-servrar via stdio. Det gör att agentramverk och andra klienter kan prata med modellen över samma typ av API som annars förknippas med molntjänster — fast på egen hårdvara.
Detta är ett rent verktyg: inget agentlager, ingen användarhantering och inget webbgränssnitt — den som vill erbjuda modellen till en grupp bygger själv tjänsten runt om. Minnesbehovet styrs helt av vald modellstorlek, så ni planerar hårdvaran efter de modeller ni vill köra.
Användning
Passar för
- Lokal körning av kvantiserade språkmodeller på egen hårdvara
- Modellservering med OpenAI-kompatibelt API via llama-server
- Inferens på CPU när GPU saknas eller är onödig
- Agentramverk som ansluter via HTTP-API och verktygsanrop
Passar mindre bra för
- Team som vill ha en färdig tjänst med användarhantering och gränssnitt
- Fjärranvändning utan egen drift
- Otillförlitliga miljöer, där de experimentella MCP-funktionerna inte bör aktiveras
Styrkor och begränsningar
Styrkor
- Referensimplementation för GGUF, den öppna de facto-standarden
- Backends för CPU samt CUDA, Metal, Vulkan med flera
- Färdiga binärer och containeravbildning sänker tröskeln
- OpenAI-kompatibel server med stöd för verktygsanrop
- MIT-licens, gratis och transparent
Begränsningar
- Rent verktyg: inget agentlager, ingen användarhantering och inget gränssnitt
- MCP-stödet är experimentellt och begränsat till stdio
- Minnesbehovet styrs helt av vald modellstorlek
Skärmbilder
5 skärmbilder. Välj en bild för att visa den i full storlek. Svep i sidled för fler.
-
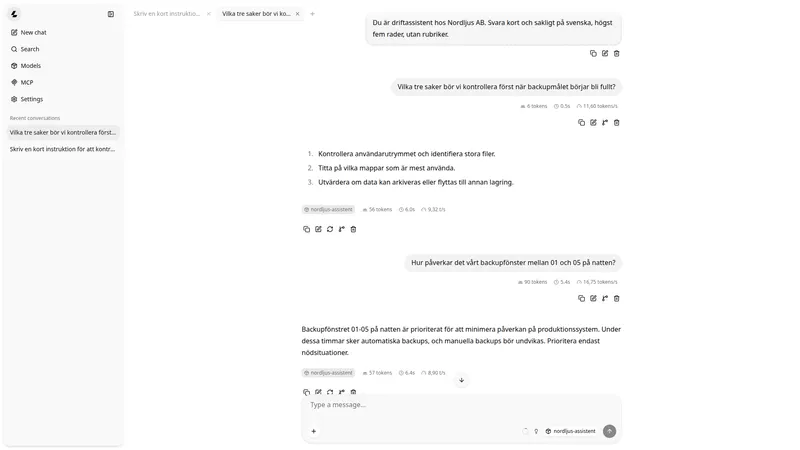
Chatten i llama-servers inbyggda webbgränssnitt med samtalslistan i sidofältet -
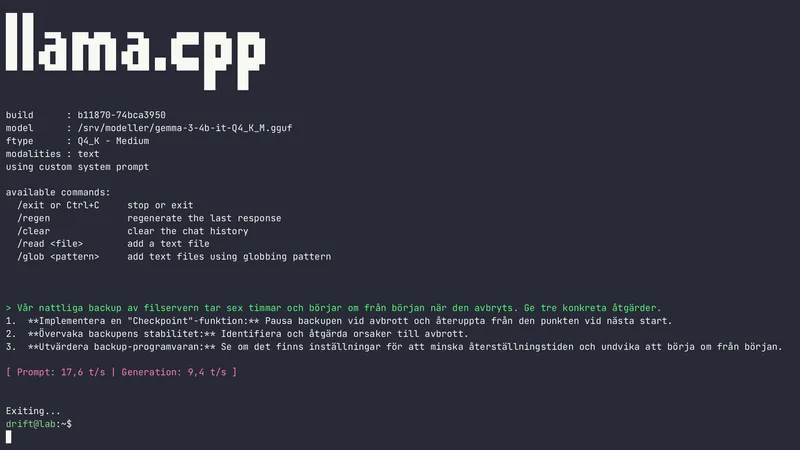
llama-cli svarar på en driftfråga direkt i terminalen -
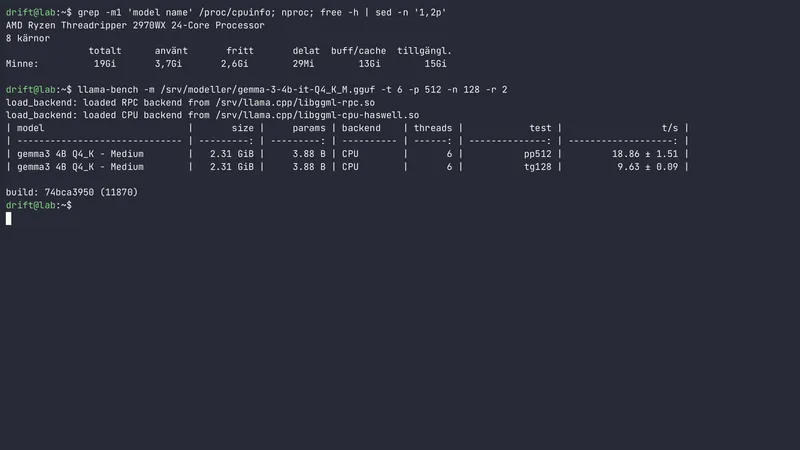
llama-bench mäter prompt- och genereringshastighet på labbmaskinens CPU -
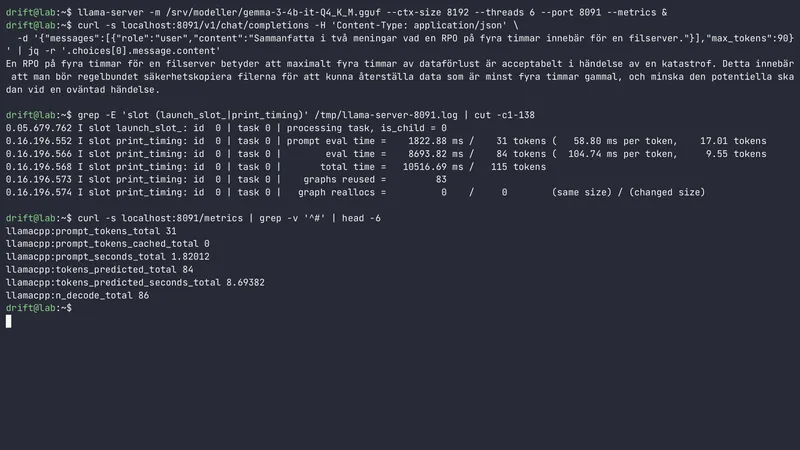
llama-server svarar på en förfrågan och loggar tidsåtgången per slot -
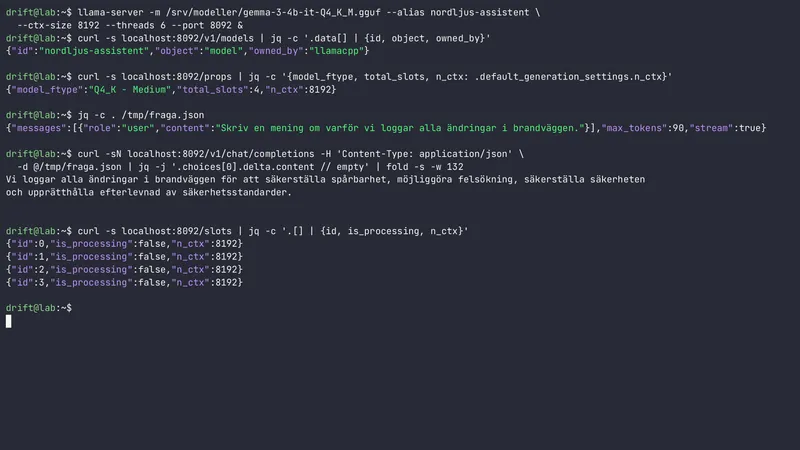
Det OpenAI-kompatibla API:t: modellista, serveregenskaper och strömmande svar
Tekniska resurser
Alternativ

vLLM
AI-körning och modellserver · Inferens- och serveringsmotor för stora språkmodeller
vLLM är en inferensmotor som serverar stora språkmodeller på egen hårdvara med hög genomströmning, känd för PagedAttention och kontinuerlig batching, med OpenAI-kompatibelt API under Apache-2.0.